Vera Rubin 等整櫃 AI 系統,讓資料中心需要同時處理更集中的用電、快速變動的負載,以及供電與冷卻的協同。800 VDC 是其中一條配電演進路線:透過較高電壓配送直流電,降低相同功率下的電流需求,並依架構調整轉換設備的位置。
這項變化會影響機房的容量分配、備援與擴充方式,也改變 GPU 託管及專屬算力服務的交付條件。
從單機到整櫃運算,供電規劃的單位也在改變
GPU 系統越集中,供電就越需要按機櫃、機櫃列與叢集規劃。機房總容量足夠,只代表上游有資源;電力仍須經過每一級設備,才能穩定送達運算系統。
| 系統類型 | 供電規劃的重點 | 常見誤判 |
|---|---|---|
| 多台獨立 GPU 伺服器 | 單機輸入、機櫃配電與同時運作負載 | 將單機額定功率直接當成整場運作耗能。 |
| GB200 NVL72 等整櫃運算系統 | 機櫃內運算、互聯、電源與液冷共同配置 | 把整櫃需求拆成一般機架空間採購。 |
| Vera Rubin 與後續高密度架構 | 提前規劃列級供電、轉換位置、負載變動與擴充 | 將平台路線圖誤當成所有設備都採同一供電方式。 |
NVIDIA 的 800 VDC 路線同時涵蓋既有 AC 設施的過渡方案與新建架構,營運商可依場地條件選擇導入方式。
800 VDC 在解決什麼問題
800 VDC 是支撐高密度 AI 運算的配電架構創新。提高配送電壓,可在相同功率下降低電流,減輕銅排、線纜與接頭的空間壓力;將部分電力轉換設備移到機櫃旁或列級設施,則能釋出運算機櫃空間,為更高功率的系統提供擴充條件。這也帶動配電、備援與維運方式調整。整體節能幅度仍由轉換器效率、線路、配送距離與負載共同決定。
依 P=V×I,忽略損耗、配送相同 100 kW 時,50 V 約需 2,000 A,800 V 約需 125 A。較高電壓用於配送,機櫃內再逐級降壓至 GPU 等元件所需電壓。
市場方案從 AC 過渡到列級與設施級直流
既有機房與新建 AI 資料中心,適合的導入路徑通常不同。保留既有 AC 配電,再於目標區域加入轉換設備,可以形成分階段部署;更大規模的新建案則可能從設施端規劃直流架構。
NVIDIA 規劃的 power rack、row power center 與 DC power block,將電力轉換位置從機櫃旁延伸到整列與設施端。下圖先比較轉換移出機櫃後的變化,再由表格整理各種部署方式。
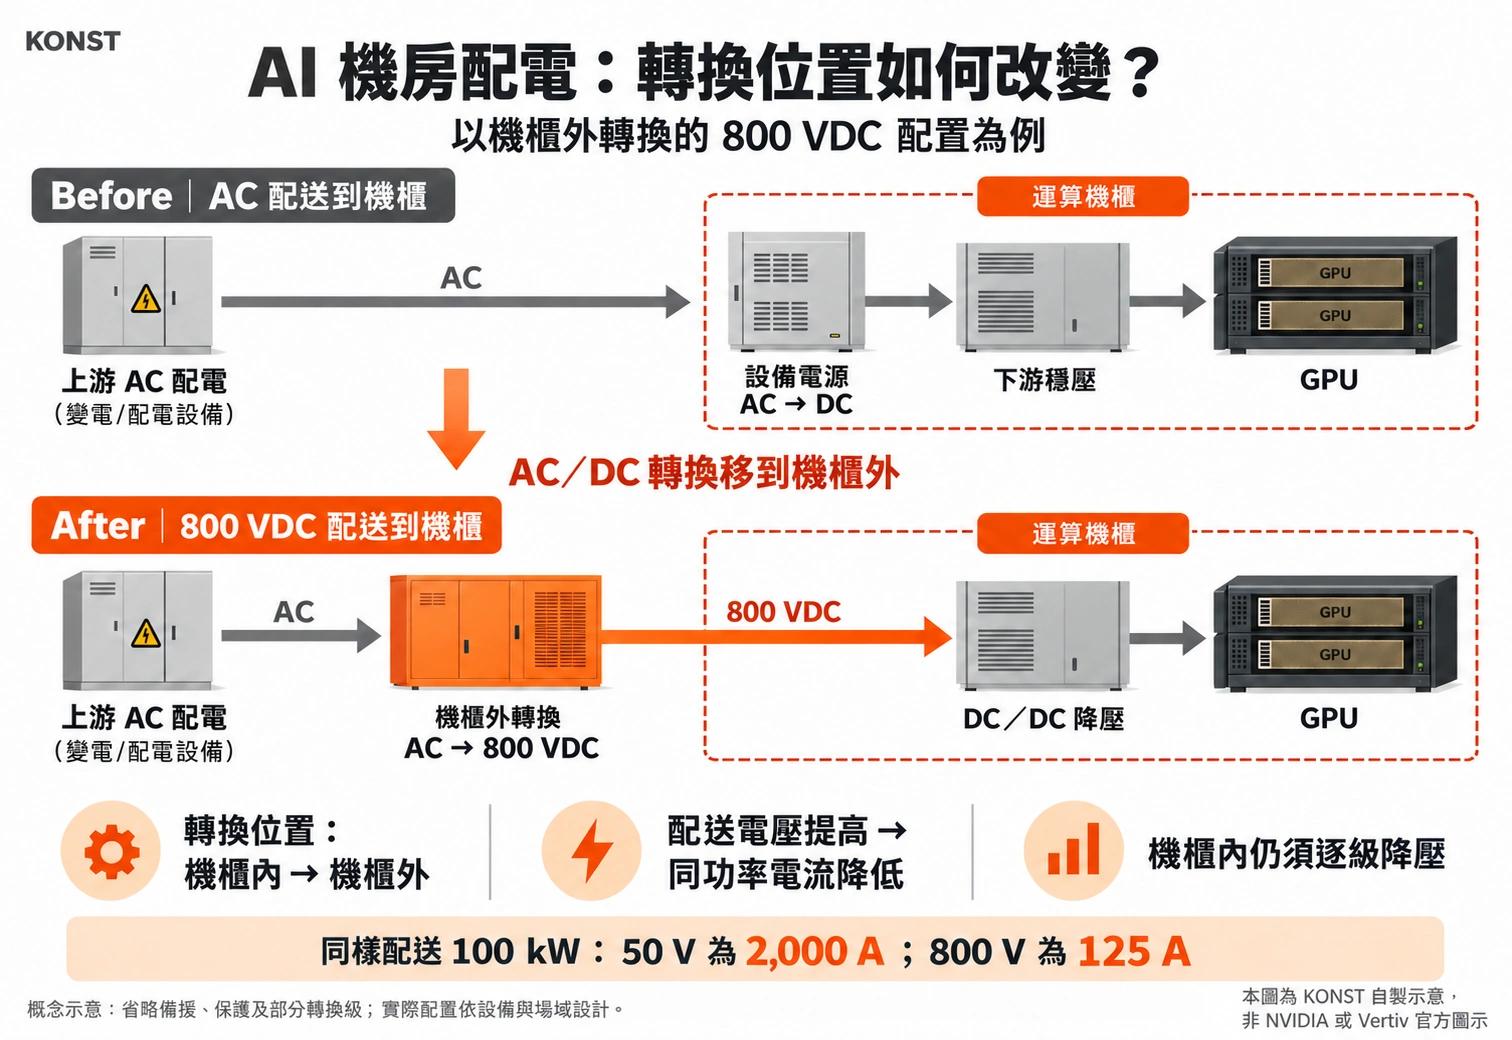
虛線框標示相同的運算機櫃邊界;橘色設備與箭頭呈現移到機櫃外的 AC/DC 轉換,以及 800 VDC 配送路徑。圖依 NVIDIA 配電架構與 Vertiv 技術說明繪製。
| 方案方向 | 供電如何安排 | 較重要的評估條件 |
|---|---|---|
| 現行 AC 配電搭配設備內轉換 | 延續場域配電,由設備電源完成下游轉換 | 是否符合目標系統要求,以及機櫃端容量是否足夠。 |
| AC 場域加 power rack/sidecar | 在接近運算區的位置轉成 800 VDC | 轉換設備空間、AC 上游餘裕、維修隔離與下游介面。 |
| 列級供電 | 對一列或多櫃共同提供配電及轉換 | 故障影響範圍、擴容方式與共用容量分配。 |
| 設施級直流架構 | 在更上游轉換並整合配送 | 新建工程、電力與儲能控制、設備供應及法規驗證。 |
Vertiv 的 sidecar 架構、Schneider Electric 的 GPU 參考設計,以及台達電的供電、儲能與冷卻整合,呈現設備商從單項產品走向整套供電方案的方向。
配電演進對機房營運與服務選擇的影響
轉換設備由多櫃共用後,營運商需要明確分配容量,並界定設備故障或維修時會影響哪些機櫃。直流配電也需要相應的保護、隔離與人員操作程序,供電、冷卻及控制系統則須共同驗收。
對採用 GPU 託管、裸機或專屬叢集的企業,這些設計最後會反映在可用容量、服務中斷與擴容條件。比較營運方案時,可以聚焦以下項目。
| 評估項目 | 可以向服務商確認的內容 | 對採用方案的影響 |
|---|---|---|
| 持續可用容量 | 每櫃或每個叢集的承諾容量、負載限制與備援後可用量 | 確認算力可在約定條件下持續使用。 |
| 設備與供電介面 | 目標機型、輸入規格及轉換設備由誰提供 | 避免進駐後才補購設備或修改工程。 |
| 異常與維修 | 任一路徑故障、設備維修時的服務影響及通知安排 | 比較真正可接受的停機風險。 |
| 冷卻與控制 | 供電、液冷與監控的責任及聯動驗收 | 確認 SLA 沒有只涵蓋部分系統。 |
| 擴容與計費 | 容量已建置、已保留或仍規劃中;何時驗收及起算 | 區分可用資源與未來選項,評估等待成本。 |
| 工作負載恢復 | 由誰重啟節點、恢復排程及讀取訓練存檔 | 避免把設施復電時間當成應用恢復時間。 |