 SERVICE| GPU 雲端服務
註冊即開通,
按秒租用 GPU
Glows.ai 是康斯特的 GPU 雲平台夥伴,算力來自康斯特自建與委任營運的機房。線上註冊、選定機型即可開通實例,作業系統、驅動與框架皆已備妥,無須自建機房與環境。實例按秒計費,關機即停,零月租與最低用量。
開源模型與工具,開機就能跑
主流開源模型與推論框架已封裝為官方映像,涵蓋語言模型、影像生成、語音合成與 Agent 四類工作負載;作業系統、驅動與相依套件預先就緒,從單卡實驗到多節點部署,皆有驗證過的組態可直接沿用。
用 Wan 2.2 開源模型量產風格化短影音
以 Wan 2.2 開源影片模型產出風格化短片,搭配 LoRA 維持角色一致性;畫面無廠商浮水印,也沒有每日生成上限。
以 Wan 2.2 圖生影片把照片轉成短片
預裝 ComfyUI 映像載入 Wan 2.2 圖生影片範本,上傳照片即可生成;單張 RTX 4090 算一支 5 秒 720p 影片不到 9 分鐘。
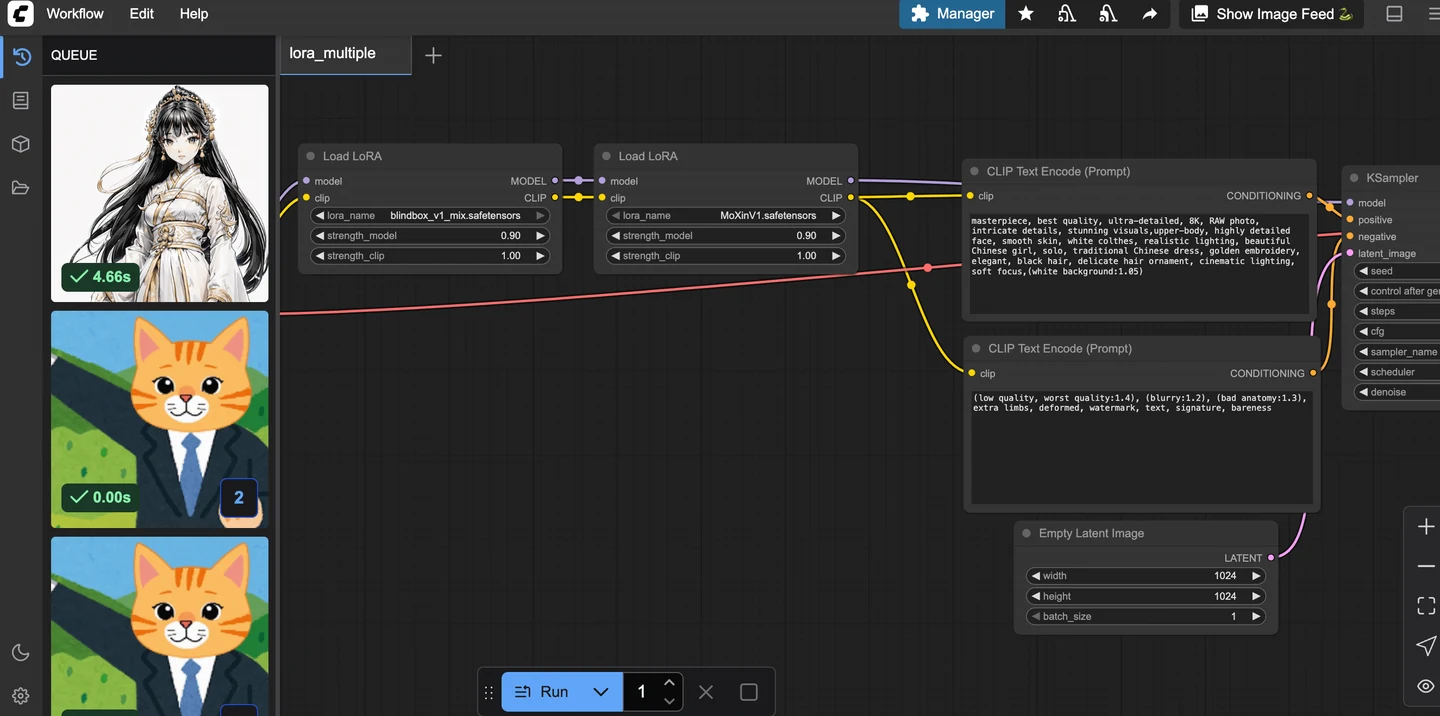
把 ComfyUI 工作流搬上雲端 RTX 4090
預配置映像開機 30 至 60 秒,RTX 4090 生成一張 1024×1024 SDXL 約 3 至 8 秒;自訂節點、模型與工作流可一併帶上雲。
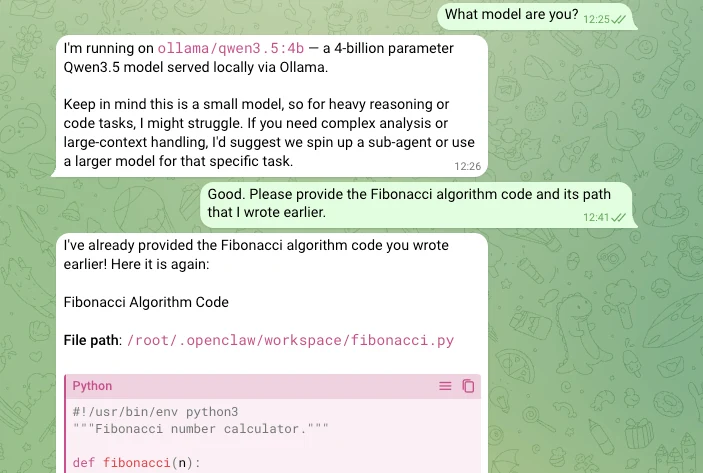
以本地模型驅動 OpenClaw 通訊 Agent
官方預裝 OpenClaw 映像內建 Ollama 跑本地模型,接上 Telegram、Slack 等通訊軟體,讓 Agent 執行指令與排程任務。
在 48 GB GPU 上自架 DeepSeek V4
V4 Flash 開放權重、上下文百萬 token,量化版需約 48 GB GPU 記憶體;選 48 GB 機型一鍵啟動實例即可自架。
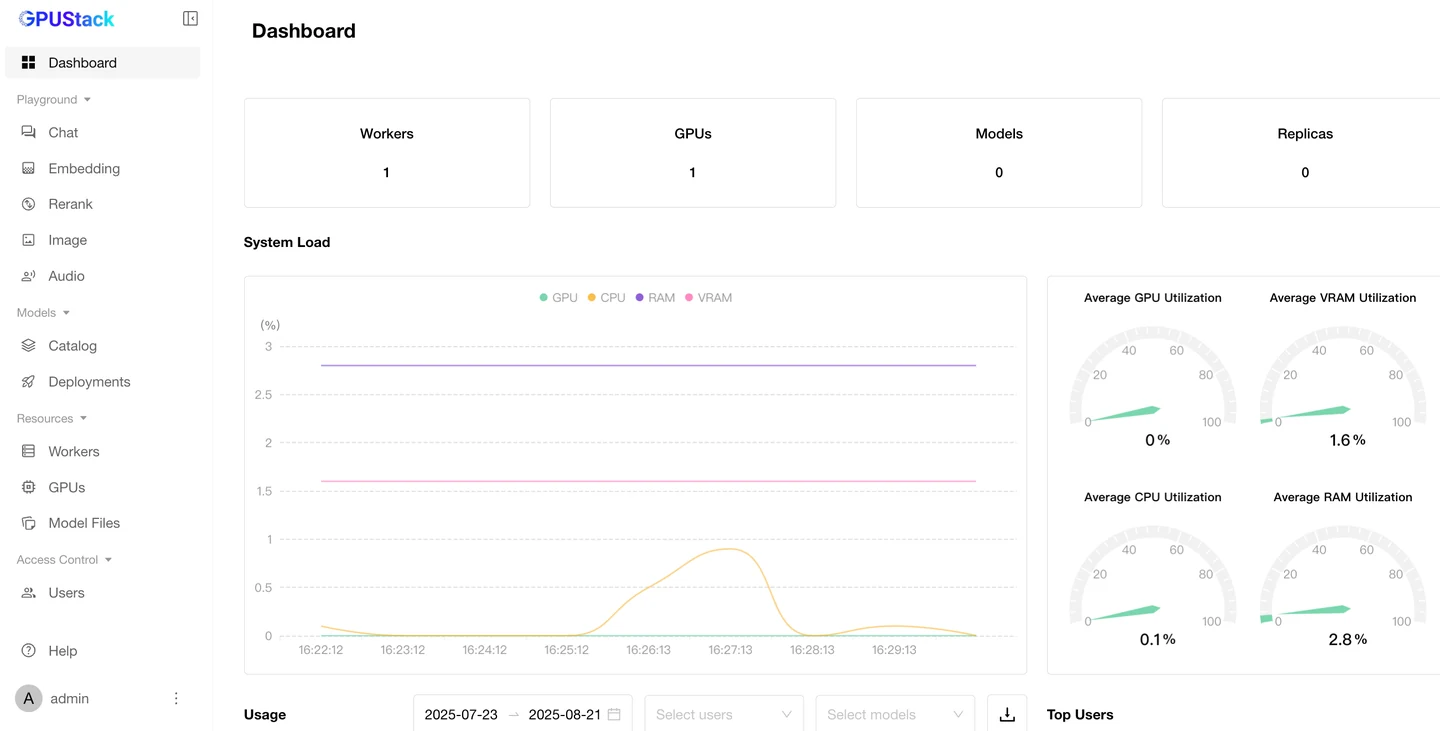
用 GPUStack 自架多卡模型服務
在實例上自架聊天介面與多卡模型服務,模型存放於 Datadrive,換實例時資料一併帶走。
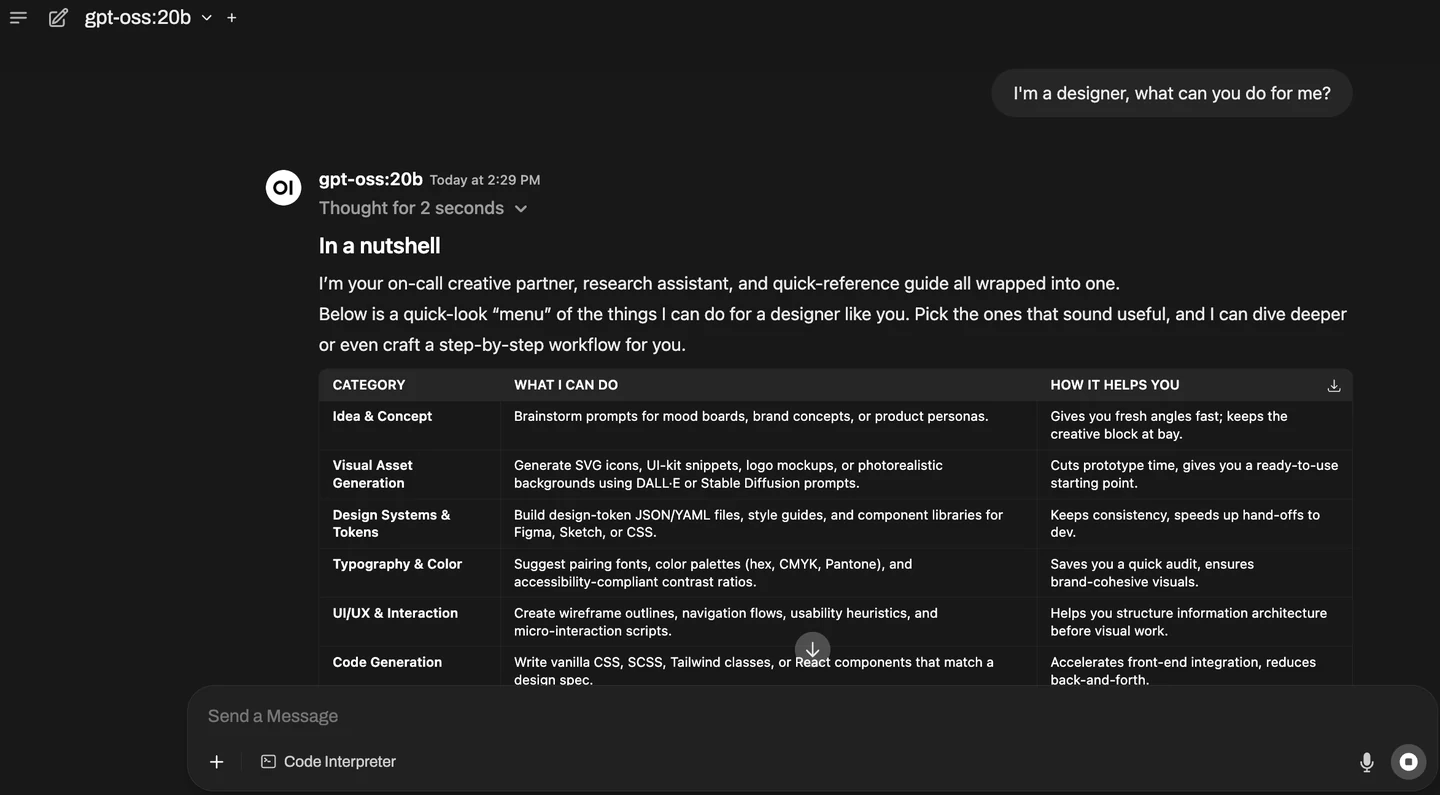
在 RTX 4090 上部署 GPT-OSS API
在 RTX 4090 實例上建立環境、呼叫 API,並以 Auto Deploy 上線;Llama 3.1 亦有快速上手映像。
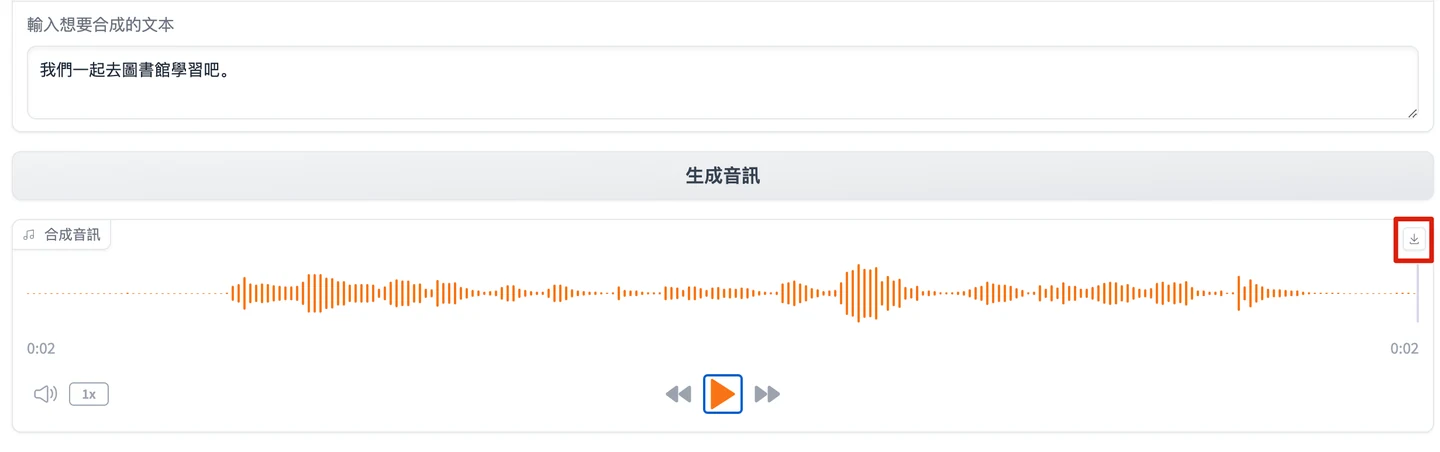
以 BreezyVoice 合成擬真個人語音
以 BreezyVoice 產生個人化語音檔;MimicTalk 文字轉語音同樣有快速上手映像。
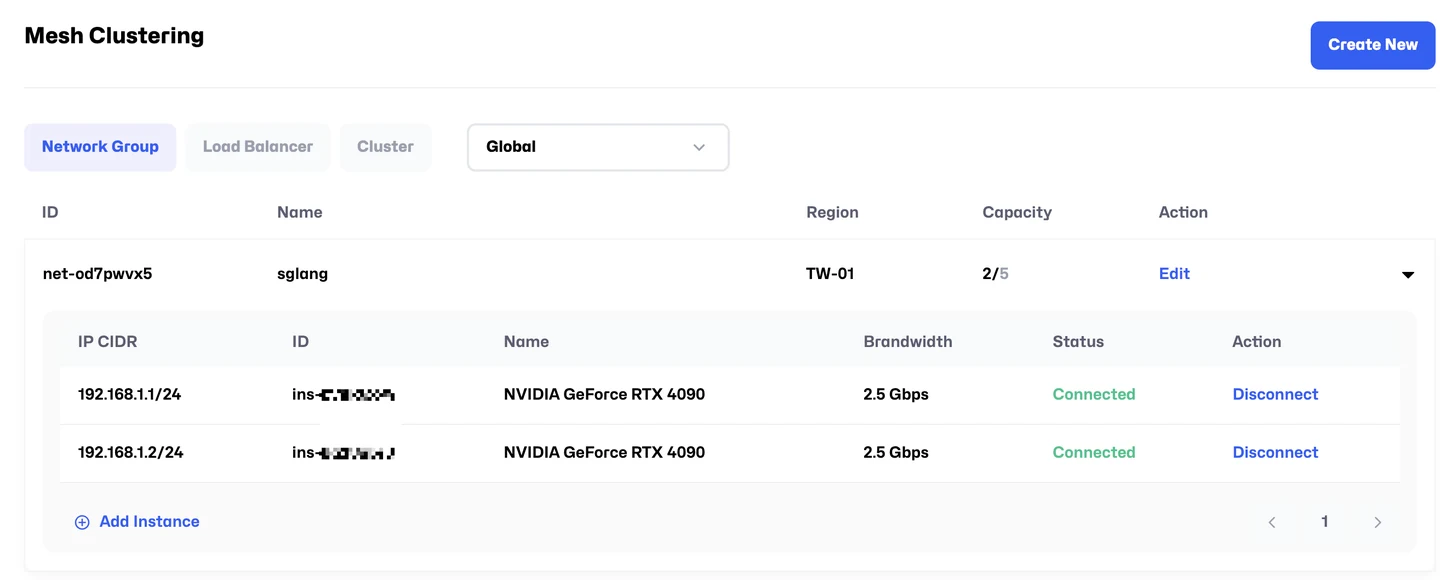
以 SGLang 多機多卡部署 DeepSeek-R1
以 SGLang 在多節點、多 GPU 環境部署 DeepSeek-R1,單機版亦可一鍵啟用。


訓練、推論、資料、協作,
四條產品線一個帳戶
從單卡實驗到多節點訓練、從共用端點到專屬推論,Glows.ai 把算力、資料與團隊工作流放在同一個平台,依工作負載挑選對應產品。
按需雲端 · 叢集
- 按需雲端單卡至多卡實例,預載框架映像,兩分鐘內開出環境
- 虛擬化按需叢集多節點併為資源池,保留按需計費的彈性
- 裸機叢集專屬 H100、A100 多節點,直接存取硬體與高速互連
雲端推論 · 專屬推論
- 雲端推論模型部署為 HTTP 端點,依請求量自動擴展,只付運算時間
- 專屬雲端推論保留固定資源,效能可預期,適合延遲敏感與受監管產業
Datadrive · 資料引擎
- Datadrive掛載於 /datadrive 的持久分散式儲存,資料集與權重跨實例重用
- 儲存訓練資料、checkpoint 與模型產出的高效能儲存
- AI 驅動資料引擎資料匯入、前處理到送進訓練任務
團隊版 · NeuroBase · Matrix0
- 團隊版GPU、環境、資料集與權限收進同一個協作空間
- NeuroBase視覺化 Agent 工作流程與自動化
- Matrix0以 SQL 執行分析、特徵工程、向量搜尋與 Agent 流程的 Serverless 執行環境
依用途配置 GPU:開發、團隊共用、線上推論
按需雲端開通單機或多卡實例,適合開發與短時訓練;虛擬化叢集併節點為資源池供團隊共用;推論服務分共用與專屬,因應延遲敏感的線上服務。
互動式開發與短時訓練
需要隨開隨關的實驗環境:按需開通單機或多卡實例,選定機型即可執行。
團隊共用長時訓練
多人爭用同一批卡:將多台節點併為可調配的資源池,供團隊彈性分配。
線上推論
延遲敏感、流量不可中斷:共用型按秒計費,專屬型保留固定資源。
開通即可立即訓練
不需自建機房與環境,選定機型即可執行,實例按秒計費,關機即停。
開通即用
作業系統、驅動與框架皆已備妥,註冊選機型即可開始執行。
按秒計費
零月租、無最低用量
換機型不重建
資料於開通時掛載、關機後保留,快照可還原至新實例。
資料持久保留,換機型免重建環境
資料與環境不隨實例生命週期消失,換機型、中斷或重開皆可接續前次狀態,模型與私有資料分開存放。
關機後資料持久保留
資料於開通時掛載,關機後保留,無須每次重新上傳。
環境快照儲存與還原
快照儲存整個環境狀態,換機型或中斷後可直接接續。
公開取用 · 私有存放
公開模型與資料集可直接取用,私有資料存於個人帳戶空間,大容量另有高效能儲存服務。
線上自助開通,按實際用量計費
線上註冊即可自助選機型、開通實例,無須簽約;按秒計費、關機即停,無月租與最低用量;先儲值後扣用,用量花費即時可查。
九個產業的訓練與推論參考架構
每個產業方案皆對應典型工作負載、建議機型與參考架構,將產業情境直接換算為可部署的算力配置。
換用高階卡,
訓練時間從 8.5 小時縮到 70 分鐘
單價較高但執行時數大幅減少,按秒計費的總支出因此下降,時間可直接投入下一輪實驗。
從 RTX 4090 到 H100,
台灣三個可用區
按需目錄的機型、記憶體與可用區如下表,皆位於台灣 TW-02、TW-03、TW-04;整批多節點 H100、A100 改走裸機叢集。
| GPU 機型 | GPU 記憶體 | vCPU | 系統記憶體 | 可用區 | 適合 |
|---|---|---|---|---|---|
| NVIDIA H100 80GB HBM3 | 80 GB | 16 | 224 GB | TW-02 | 大型模型微調、高吞吐推論 |
| NVIDIA RTX PRO 6000 | 96 GB | 14 | 48 GB | TW-04 | 大 GPU 記憶體推論、影像生成 |
| NVIDIA A100 SXM4 | 80 GB | 16 | 80 GB | TW-04 | 訓練與微調 |
| NVIDIA L40S PCIe ×8 | 48 GB /卡 | 160 | 1,792 GB | TW-04 | 多卡平行訓練 |
| NVIDIA L40S PCIe | 48 GB | 12 | 80 GB | TW-04 | 推論、影像與影片生成 |
| NVIDIA RTX 6000 Ada | 48 GB | 12 | 80 GB | TW-04 | 開發與中型推論 |
| NVIDIA GeForce RTX 4090 | 24 GB | 10 | 50 至 64 GB | TW-03 · TW-04 | 實驗、ComfyUI、7B 至 20B 級模型 |
規格取自 glows.ai/llms-full.txt(2026-10-06 抓取);機型供應隨時變動,各機型牌價請見價格頁。
團隊集中儲值,依角色分配額度
一個帳戶管理多位成員,額度集中儲值後分配,無須各自付費;管理者可限定成員可用機型與映像檔,避免額度開在高階卡上。
權限團隊的建立與擁有者,具備全部權限
權限開通帳號、分配額度、控管資源權限、釋放實例
權限依額度與資源權限開通與使用實例
資安認證、原廠夥伴,
與硬體生態一起建
平台通過 ISO/IEC 27001:2022 資訊安全管理認證,採用 NVIDIA 認證硬體,並與台灣硬體與系統廠合作建置。


常見問題
Glows.ai 的 GPU 雲收費怎麼算?
學校或研究單位有專案方案嗎?
換機型會不會要重建環境?
小模型和大型模型該用哪種卡?
常一起評估的服務
想開出第一個 GPU 實例嗎?
說明團隊規模與使用情境,我們回覆適用的方案與額度配置