Vera Rubin 是 NVIDIA 面向大型 AI 訓練與推論的新一代運算平台,核心由 Vera CPU、Rubin GPU 與高速互聯組成。它受到關注,是因為 AI 正從回答單次問題,走向持續推理、使用工具與執行任務;背後需要處理的資料與運算量,也隨之增加。
依 NVIDIA 的季度法說會,Vera Rubin 已於 2026 年 8 月開始量產出貨。對企業而言,接下來要理解的是:新平台改善哪些瓶頸、效能數字如何解讀,以及這些進步如何轉化為實際可部署的算力。
Vera Rubin 進展到哪裡?從發表、量產到出貨
Vera Rubin 已從產品發表進入量產出貨階段,但企業何時能採購設備或租用算力,仍取決於實際交付地區、容量與服務上線時間。原廠出貨與企業取得可用環境,是供應鏈上的不同節點。
| 時間 | 公開進展 | 對企業的意義 |
|---|---|---|
| 2026 年 1 月 | NVIDIA 在 CES 發表 Rubin 平台,宣布進入全面生產,當時預告合作夥伴產品於下半年供應 | 平台與產品方向確立,尚不能據此推定各地都有可租用容量 |
| 2026 年 8 月 | NVIDIA 在 2026-08-26法說會確認,當月已開始量產出貨 | 原廠供貨進入執行階段,設備商與算力業者可接續整合及部署 |
| 企業實際導入時 | 依設備交期或雲端方案確認上架、測試與可使用日期 | 採購應以能開始執行工作負載的時間排程 |
設備到貨後,仍需要接妥液冷、完成網路設定與模型測試,才能投入正式工作;租用雲端資源,也要確認指定區域是否已開放所需規模。
Vera Rubin 是什麼?看懂 CPU、GPU 與平台架構
Vera 是 CPU,Rubin 是 GPU;Vera Rubin 則把兩者與互聯、網路及軟體納入共同設計。理解這個層級差異,才能看懂新聞談的是晶片能力、整櫃效能,還是整座 AI 資料中心的產出。
以 Vera Rubin NVL72 為例,一個機櫃級系統整合 36 顆 Vera CPU 與 72 張 Rubin GPU,並透過第六代 NVLink 讓 GPU 高速交換資料。
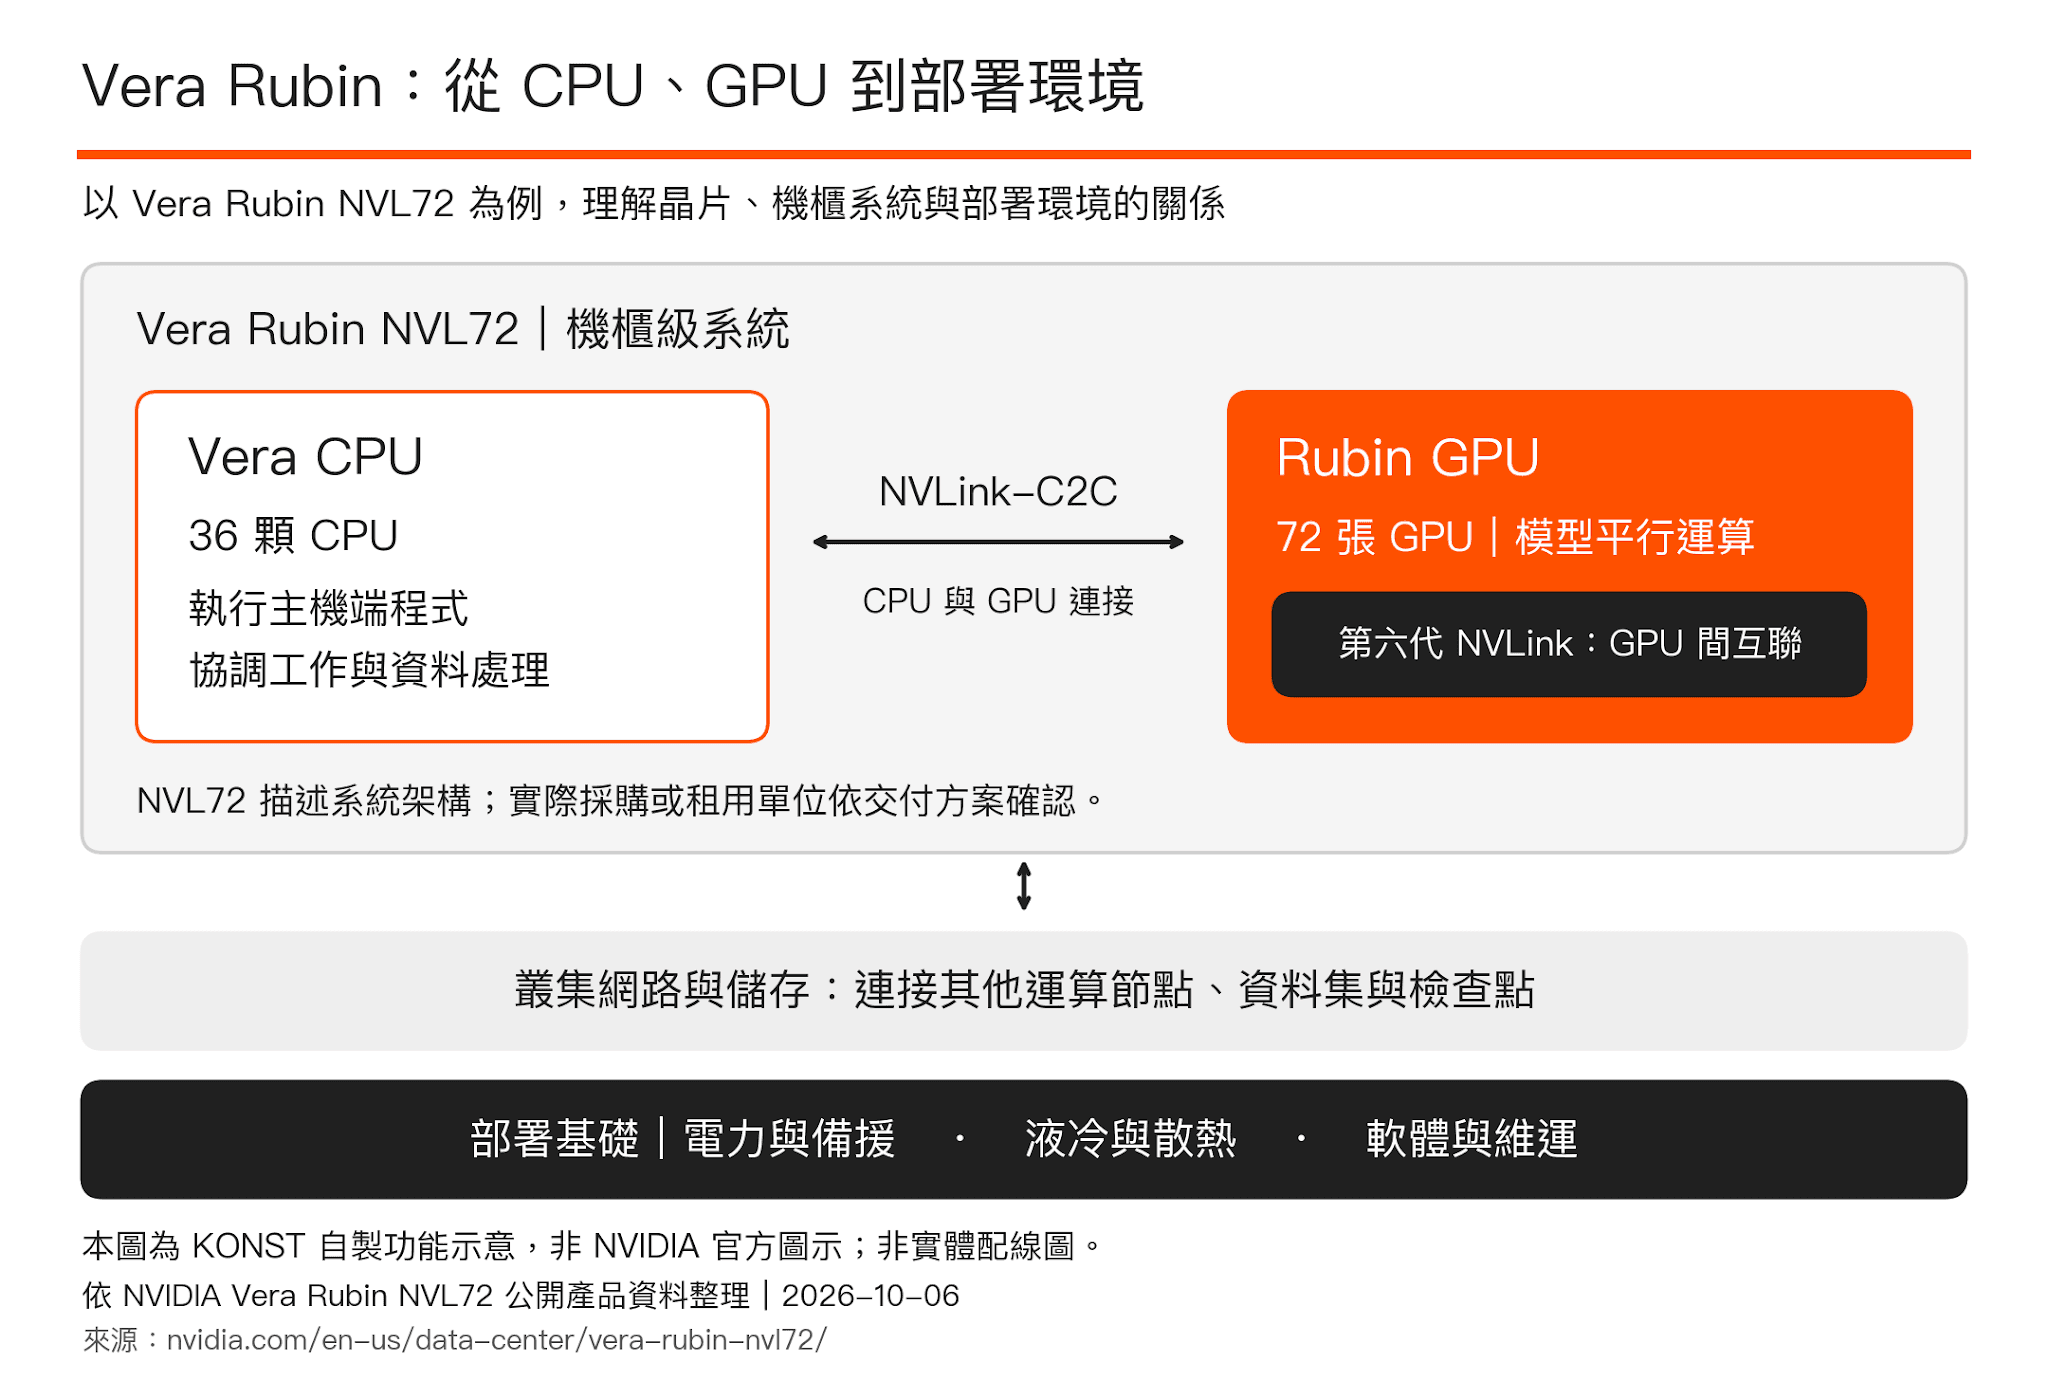
圖:Vera Rubin NVL72 功能與層級示意。KONST 自製,非 NVIDIA 官方圖示;依 NVIDIA 公開產品資料整理。
各部分解決的問題不同:CPU 負責執行主機端程式與協調工作,GPU 承擔模型的大量平行運算,NVLink 降低 GPU 之間交換資料的阻力。系統再透過叢集網路連接其他運算節點與儲存,擴大可處理的工作規模。
這也是平台設計的重要性:當一個模型需要多張 GPU 合作,運算速度會同時受到資料搬移、互聯與軟體排程影響。單張 GPU 的峰值算力,只能說明其中一部分。
AI Agent 為什麼需要新一代算力
AI Agent 在完成一項任務時,可能反覆呼叫模型、讀取工具結果並累積上下文。任務變長、同時服務的人數增加後,推論速度、記憶體與資料傳輸效率會共同影響完成時間與成本,這也是新一代算力平台著重改善的方向。
例如,要求 AI 整理一份採購研究,它可能先搜尋資料、閱讀文件、比較條件,再補查缺漏並產出報告。每次取得新資料,都可能觸發新的推論;任務越長,需要保留的上下文也可能越多。
這類工作對算力提出三種需求:
- 更長的上下文處理能力: 模型要處理文件、對話紀錄與工具回傳,GPU 記憶體及資料讀取效率會影響可承載的任務規模。
- 多輪推論的回應速度: 單次生成省下的時間,可能累積成整個任務的時間差;同時服務多人時,也要維持可接受的等待時間。
- 跨 GPU 協作效率: 大型模型分散在多張 GPU 上,資料交換效率會影響 GPU 能否持續工作,尤其是需要在不同專家模組間分派運算的混合專家模型(MoE)。 NVIDIA 的 Rubin 技術說明將運算、互聯與推論上下文管理納入共同設計。不過,Agent 的整體速度還受到搜尋、外部 API 與工具執行時間影響;若主要等待發生在這些環節,升級 GPU 能改善的部分就有限。
Vera Rubin 的推論成本下降,會讓 AI 服務降價嗎?
Vera Rubin 提升推論效率,可能降低系統產生 Token 的成本;雲端租金與模型 API 費率是否調降,仍取決於服務商定價。閱讀原廠效能倍數時,應連同比較平台、模型與測試條件一起看。
例如,NVIDIA 在 2026 年 1 月的發表資料中,提出相較 Blackwell 平台,Rubin 的推論 Token 成本最高可降至約十分之一。這是特定平台比較下的原廠主張,不能直接套成「所有 AI 服務都降價九成」,也不能改寫為對 GB300 的通用倍數。
隨平台與軟體持續更新,後續資料也可能出現不同效能倍數。閱讀時應先確認比較的是單一 NVL72 系統,還是加上其他推論設備的整體架構,以及數字屬於實測或預估。
| 成本層級 | 衡量的內容 | 企業應如何理解 |
|---|---|---|
| 系統運算成本 | 硬體、電力、冷卻與營運投入,相對於實際產出 | 用相同模型、品質與延遲條件比較單位產出成本 |
| 雲端算力價格 | 使用 GPU、伺服器或專屬容量的服務費 | 還受地區、租期、容量保障及包含項目影響 |
| 模型 API 費率 | 模型供應商對輸入、輸出或其他用量收費 | 還包含模型服務、產品策略與商業定價,須看實際價目表 |
對企業推論服務,較有意義的問題是:「在相同回答品質與等待時間下,每月能完成多少合格請求?」若是 AI Agent,還可進一步看每個成功任務的總成本,將多次推論、工具費用與重試一併納入。
這樣才能辨認硬體效率是否真正轉化為業務成本改善,而非只看到更高的峰值運算數字。
Vera Rubin 對企業部署帶來哪些改變
導入 Vera Rubin 需要把設備與場域一起規劃,才能讓新增算力穩定投入工作。以 NVL72 這類機櫃級系統而言,電力、液冷、互聯與軟體環境都會影響上線時間及持續運作的效能。
電力要對齊整個系統的需求。 機櫃、網通、儲存與冷卻設備都需要容量,還要考慮備援及負載變動。採購時應依實際設備配置核對可用供電,並將後續擴充納入規劃。
冷卻要接得上設備,也要把熱排得出去。 Vera Rubin NVL72 採直接液冷設計。現場需依目標配置核對冷卻液分配裝置(CDU)、管路與散熱能力,並約定建置、測試和維護的分工,才能讓設備到貨與冷卻工程順利銜接。
互聯與儲存要跟得上工作負載。 機櫃內 GPU 的高速互聯,與機櫃間的叢集網路各有任務。大型訓練若需要跨櫃交換資料,或頻繁讀寫資料集與檢查點,應同步驗證網路和儲存,避免 GPU 因等待資料而閒置。
軟體需要用實際任務驗證。 驅動程式、運算框架、推論引擎與模型設定共同決定效能。硬體規格提升後,仍要確認現有模型能否順利執行,並以代表性工作測試延遲、吞吐量與穩定性。
對租用算力的企業,這些工程多由服務商承接;企業仍需要確認交付的是硬體使用權、已建置的叢集,還是包含軟體管理的服務,讓維運責任與預期一致。
KONST 如何承接新世代 AI 算力需求
KONST Group(康斯特超算集團)提供 GPU 裸機租賃與專屬叢集服務,而旗下 Konstra AI 則承接 AI 資料中心的算力建設,涵蓋機電、環控到 GPU 叢集的整體建置,以及設備維運與算力交付。企業可依上線時間、運算規模與場地條件,選擇取得既有算力,或規劃專屬部署環境。
需要先執行模型與開發工作的團隊,可從 GPU 裸機服務確認合適的機型與交付條件;需要長期擴大 GPU 規模的企業,則可將叢集與 AIDC 建置一起規劃,讓電力、冷卻及後續營運配合工作負載成長。
Vera Rubin 的特定供應方案、交付地點與時程,須另行確認。KONST 可先承接企業的算力與設施規劃需求,再依已確認的設備與容量安排部署。