ASIC(Application-Specific Integrated Circuit,特定應用積體電路)是為特定用途設計的晶片,應用涵蓋通訊、影像處理與 AI 運算。AI 專用晶片則把運算單元、記憶體與資料傳輸方式,配合神經網路的運算需求共同設計。
Google、AWS 與 Meta 持續投入自研 AI 晶片,讓專用加速器成為大型平台規劃算力的重要選項。Google TPU 加速機器學習工作負載;AWS 以 Trainium 與 Inferentia 布局訓練和推論;Meta 則以 MTIA 承接推薦、排序等自家服務的運算需求。
這些平台有持續且大規模的運算需求,能從模型、軟體到硬體共同設計,追求更合適的效能與成本。隨著 AI 服務擴大,專用晶片的競爭也延伸到獨立加速器業者、伺服器系統與推論雲端,形成多種技術與商業路線。
近期其他業者的動向,也呈現不同的商用路線。2026 年 9 月,d-Matrix 宣布採用 NVIDIA NVLink Fusion,規劃讓下一代 Raptor 加速器接入 NVIDIA 機櫃架構;Cerebras 則宣布與 Gimlet Labs 合作,將晶圓級運算接上推論雲端。加上 Rebellions 的機櫃平台、SambaNova 的可重組資料流架構,以及 Groq 的低延遲推論服務,專用晶片的競爭正從晶片效能延伸到系統整合與服務交付。
ASIC、GPU、NPU 與 TPU 的差異
ASIC 強調為特定用途設計;GPU 擅長平行運算;NPU 則是神經網路處理單元的通稱。理解這些名稱,有助於看懂 AI 晶片業者的設計方向。
| 名稱 | 可以如何理解 | 設計重點 |
|---|---|---|
| ASIC | Application-Specific Integrated Circuit,特定應用積體電路 | 針對特定運算與資料路徑設計,常見於通訊、影像及 AI。 |
| GPU | 可執行多類平行運算的處理器,AI GPU 也包含專用矩陣運算單元 | 透過可程式化平行運算與軟體生態,支援多種工作負載。 |
| NPU | 神經網路處理單元的通稱,各廠實作差異很大 | 加速神經網路常用運算,涵蓋終端裝置與資料中心。 |
| TPU/LPU/RDU | 不同供應商對其加速器的命名與架構設計 | 分別代表 Google、Groq、SambaNova 的加速器路線。 |
專用晶片可搭配編譯器支援多個模型。例如 Google TPU 執行張量運算,Rebellions 則以 SDK 銜接模型框架;軟體負責將模型轉換為硬體可執行的運算。
持續推論需求,讓專用晶片有發揮空間
推論是模型投入服務後反覆執行的運算。客服、搜尋摘要與 AI Agent 每次回應都會消耗算力;當請求持續累積,回應速度與每次運算的耗電量就成為服務成本的重要來源。
訓練偏重模型建立與更新,推論則要在使用者等待時間、同時請求數與成本之間取捨。例如線上客服重視第一個回答出現的時間,批次文件處理更在意整段時間完成多少工作。相同晶片在兩種情境下的價值可能不同。
這讓記憶體容量、資料搬移與系統互聯成為專用晶片的競爭重點。晶片業者一方面縮短資料在記憶體與運算單元之間的移動,另一方面搭配編譯器、模型支援與服務框架,將硬體效率帶進實際應用。
六家 AI 專用晶片玩家的定位比較
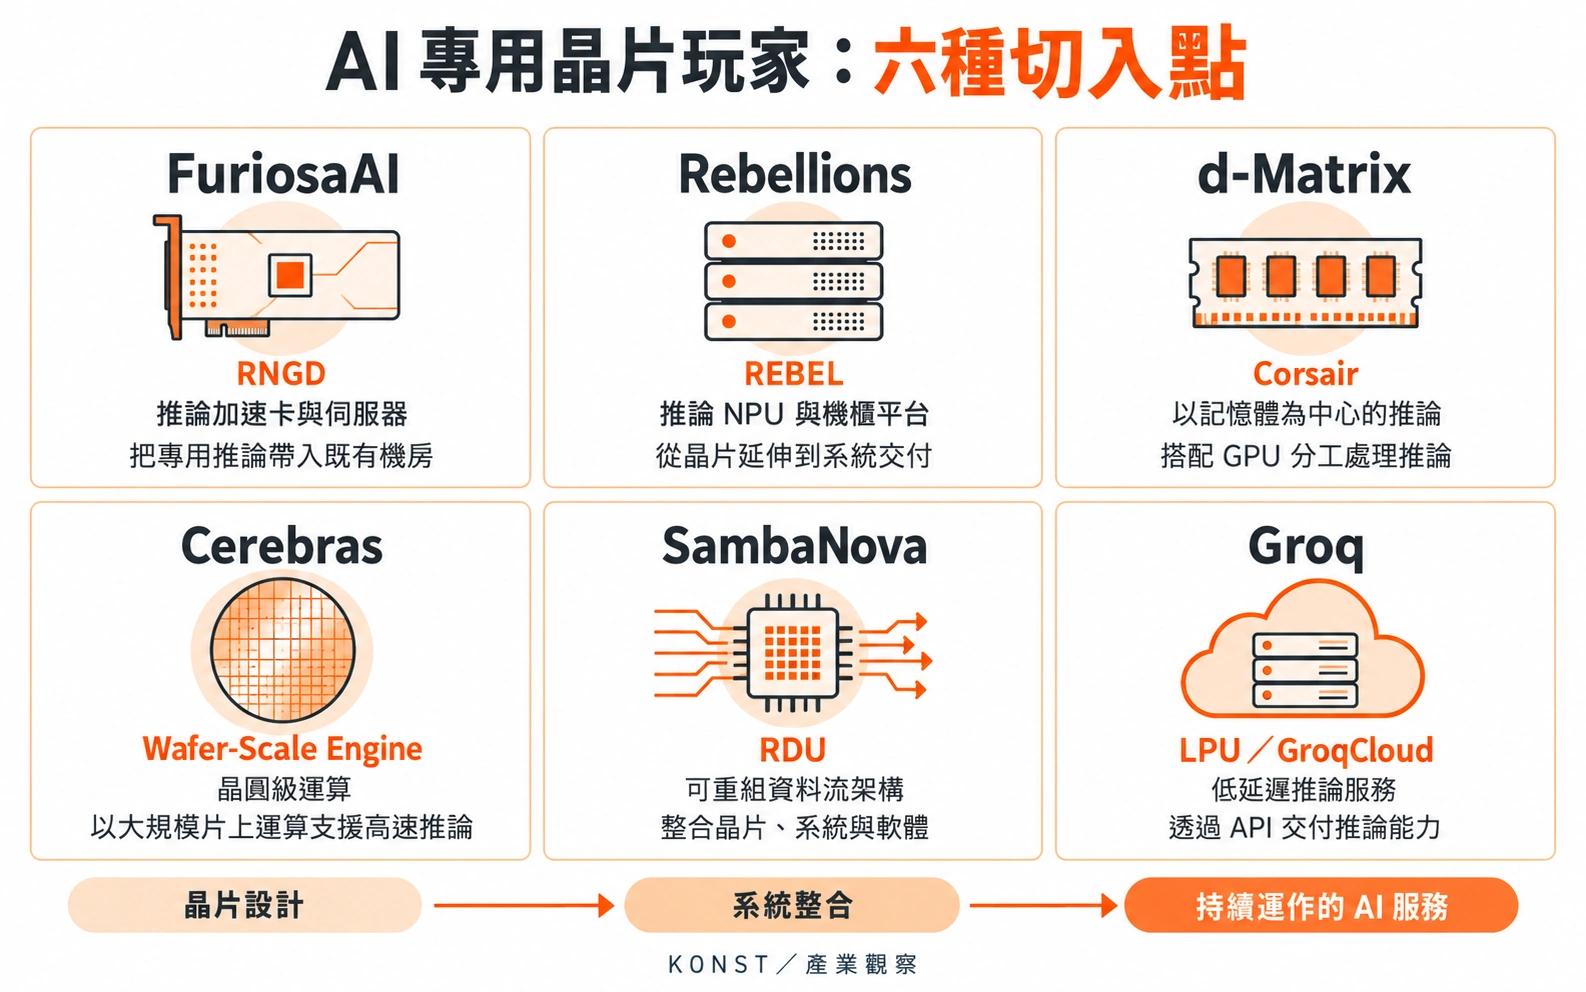
在大型平台的自研晶片之外,以下六家業者呈現不同的技術與市場切入點:有的提供加速卡,有的交付整套運算系統,也有的透過雲端 API 提供推論。選擇這六家比較,是為了看懂專用晶片如何走向商用,以及各自著重的架構與交付形式。
| 公司/代表技術 | 技術路線 | 市場定位 |
|---|---|---|
| FuriosaAI/RNGD | 以 RNGD 推論加速器搭配 PCIe 卡與伺服器 | 將專用推論部署到企業及資料中心環境 |
| Rebellions/REBEL | 推論 NPU、chiplet 設計與軟體工具 | 從晶片延伸至 RebelRack、RebelPOD 等系統平台 |
| d-Matrix/Corsair | 記憶體與運算共同設計,降低資料搬移負擔 | 以 Corsair 搭配 GPU,切入低延遲推論及機櫃部署 |
| Cerebras/Wafer-Scale Engine | 以晶圓級引擎整合大量運算與片上記憶體 | 提供運算系統及高速推論雲端服務 |
| SambaNova/RDU | 以 RDU 可重組資料流架構搭配軟體 | 整合晶片、系統與企業推論平台 |
| Groq/LPU 與推論服務 | 以 LPU 加速推論,強調低延遲生成 | 以 GroqCloud API 交付推論能力 |
這些路線也開始形成合作。Groq 與 NVIDIA 在 2025 年 12 月公布非獨家推論技術授權協議,NVIDIA 並延攬其創辦團隊,顯示獨立業者與平台廠之間的界線正在移動。d-Matrix 的 Corsair 則與 GPU 搭配,分工處理提示詞運算與後續 Token 生成。專用晶片的角色正延伸到異質運算系統。
從自研自用到對外服務,專用晶片的三種商業路線
專用晶片的商業化方式,取決於業者掌握哪些客戶與系統能力。大型平台可先承接自己的工作負載,再延伸至雲端服務;獨立晶片業者則需要讓其他企業能夠部署或直接使用其算力。
一、大型平台將晶片與工作負載共同設計。Google TPU 與 AWS Trainium 結合各自的雲端平台;Meta MTIA 則針對自家推薦與排序等需求設計。平台能把應用需求直接帶進晶片與系統規劃,並以持續的運算量支撐開發投入。
二、加速器業者將晶片做成可部署的系統。FuriosaAI 以 RNGD 加速卡與伺服器接入資料中心,Rebellions 則推進機櫃平台。這條路線需要同步提供模型工具、伺服器配置與互聯能力,讓客戶能把晶片納入既有運算環境。
三、以雲端服務降低硬體導入門檻。GroqCloud API 與 Cerebras 的推論服務,讓開發者直接取得運算能力。這類模式把設備部署與維運集中在服務端,競爭也延伸到模型支援、回應速度及持續服務能力。
AI 晶片的下一階段:工作負載分工與系統競爭
一、推論會出現更細的硬體分工。提示詞處理與逐步生成 Token 的運算特性不同,d-Matrix 與 GPU 的搭配已展示這種方向。未來平台的競爭,將包含如何把不同任務分配給合適的加速器。
二、競爭單位會從晶片擴大到系統。雲端大廠整合自研晶片與平台,專用加速器業者則補上伺服器、互聯及模型工具。硬體效率能否轉成實際服務能力,取決於整套系統的配合。
三、取得算力的方式會更多元。企業可透過雲端服務使用專用晶片,也可將加速器部署在自有環境。軟體介面與模型工具越成熟,硬體架構與上層應用之間的銜接就越容易。
ASIC 的發展讓 AI 算力走向更細緻的分工。大型平台、晶片業者與系統整合商各有角色;下一階段的競爭,將圍繞特定工作負載的效率、可部署的系統,以及能持續交付的運算服務展開。
異質算力的落地,需要機房與系統整合
當 GPU 與專用加速器分工承接 AI 任務,部署也需要整合不同設備的供電、冷卻、網路與維運條件。從單一晶片走向異質算力,機房能否容納設備、系統之間如何交換資料,以及後續如何擴充,都會影響服務落地。
KONST Group(康斯特超算集團)承接 AI 資料中心的新建、改造與擴充需求;KONST 旗下的 Konstra AI 提供機電、環控、GPU 叢集建置與後續維運。企業規劃不同運算設備時,可從目標系統的規格出發,討論機櫃配置、電力與冷卻容量,以及設備端與現場設施的介面分工。
聯絡 KONST,討論 AI 資料中心與算力整合需求。