GPT-6 Astra 是 OpenAI 的 AI 模型,主打需要推理、操作工具與持續執行的複雜工作。它受到關注的原因,是 AI 能承接的任務逐漸從回答問題,延伸到整理資料、修改程式與產出文件。不過,模型在特定測試取得高分,仍不足以直接判定它已達到通用人工智慧(AGI)。
對使用者而言,更實際的問題是:Astra 能幫忙完成哪些工作?和前代模型相比,是否能減少來回指導與修正?使用前又需要準備哪些工具和資料?
GPT-6 Astra 是什麼?和 ChatGPT 有什麼關係
GPT-6 Astra 是負責理解、推理與生成內容的模型;ChatGPT 是使用者與 AI 互動的產品;API 則讓開發者把模型接入自己的應用。同一個模型透過不同產品使用,可取得的工具、資料與執行權限也會不同。
例如,在聊天介面請 AI 規劃一份研究報告,與讓它讀取公司文件、搜尋網路並建立可編輯檔案,是兩種不同的工作環境。後者需要文件存取、搜尋與檔案產出工具,也需要明確的授權範圍。
GPT-6 Astra 模型文件列出的能力涵蓋推理、程式、電腦操作、研究及文件工作。這些能力提供應用基礎,實際能完成的動作仍取決於使用平台是否接好相應工具。
GPT-6 Astra 真的達到 AGI 了嗎?
目前的公開證據可以支持 Astra 在部分複雜任務上有顯著進展,但不足以把「已達 AGI」當成確定結論。AGI 通常用來描述能廣泛學習、理解並處理不同領域工作的人工智慧;判定時需要說明能力範圍、可靠程度與測試條件。
測試名稱裡有 AGI,也不代表通過該測試就取得 AGI 認證。以 ARC Prize 的 Astra 評測為例,Astra 在 ARC-AGI-3 Semi-Private 的標準測試環境、max 推理設定取得 62.7%,使用能保留推理狀態的供應商介接環境、high 推理設定則取得 99.9%。
這也說明,AI 的工作成果來自模型與執行環境的配合。資料是否完整、先前步驟能否保留、工具是否可用,都可能改變結果。企業導入時,應把自己的任務完成率與人工覆核需求列為驗證重點。
與前代模型相比,Astra 主要進步在哪裡
以 GPT-5.6 Sol 作為前代比較對象,Astra 的主要進步是更能在長任務中維持目標與前後一致,並遵循較長、較複雜的指令。同時,它也更傾向先詢問不明確的要求;能否減少返工與人工投入,仍要以相同任務測試。
OpenAI 的模型使用指南將 Astra 的進步歸納為長任務的一致性、指令遵循,以及工作途中理解新要求與澄清疑問的能力。這些差異會影響模型如何與使用者合作。
| 比較面向 | 官方描述的差異與能力 | 對使用者的意義 |
|---|---|---|
| 多步驟工作 | Astra 比 GPT-5.6 Sol 更能維持長任務的前後一致 | 適合需要持續保留目標、限制與背景的工作 |
| 指令遵循 | 相較前代,Astra 更能遵循較長指令,也更敏感於規範文件 | 複雜要求更容易落實;過時或矛盾規範也更需整理 |
| 執行中調整 | Astra 可納入新要求、調整方向,並接續原有任務 | 可在工作途中修正需求;效果仍需依使用介面驗證 |
| 澄清行為 | Astra 較傾向先詢問;GPT-5.6 Sol 等前代較傾向自行假設 | 需說明可自行判斷的範圍,避免不必要的停頓 |
以上是官方描述的能力與行為差異,不代表每項工作都能省下固定比例的時間。例如,一份格式固定的短摘要,可能已由原本的模型穩定完成;需要查閱多份文件、處理矛盾資訊並修改產出的工作,才更容易看出長任務能力的差異。
從 OpenAI 公布的評測,可進一步看見 Astra 與 GPT-5.6 Sol 在執行工作上的差異。下圖呈現自動化、終端、電腦操作與網頁研究四類任務,對應使用者從查找資料到操作工具完成工作的需求。
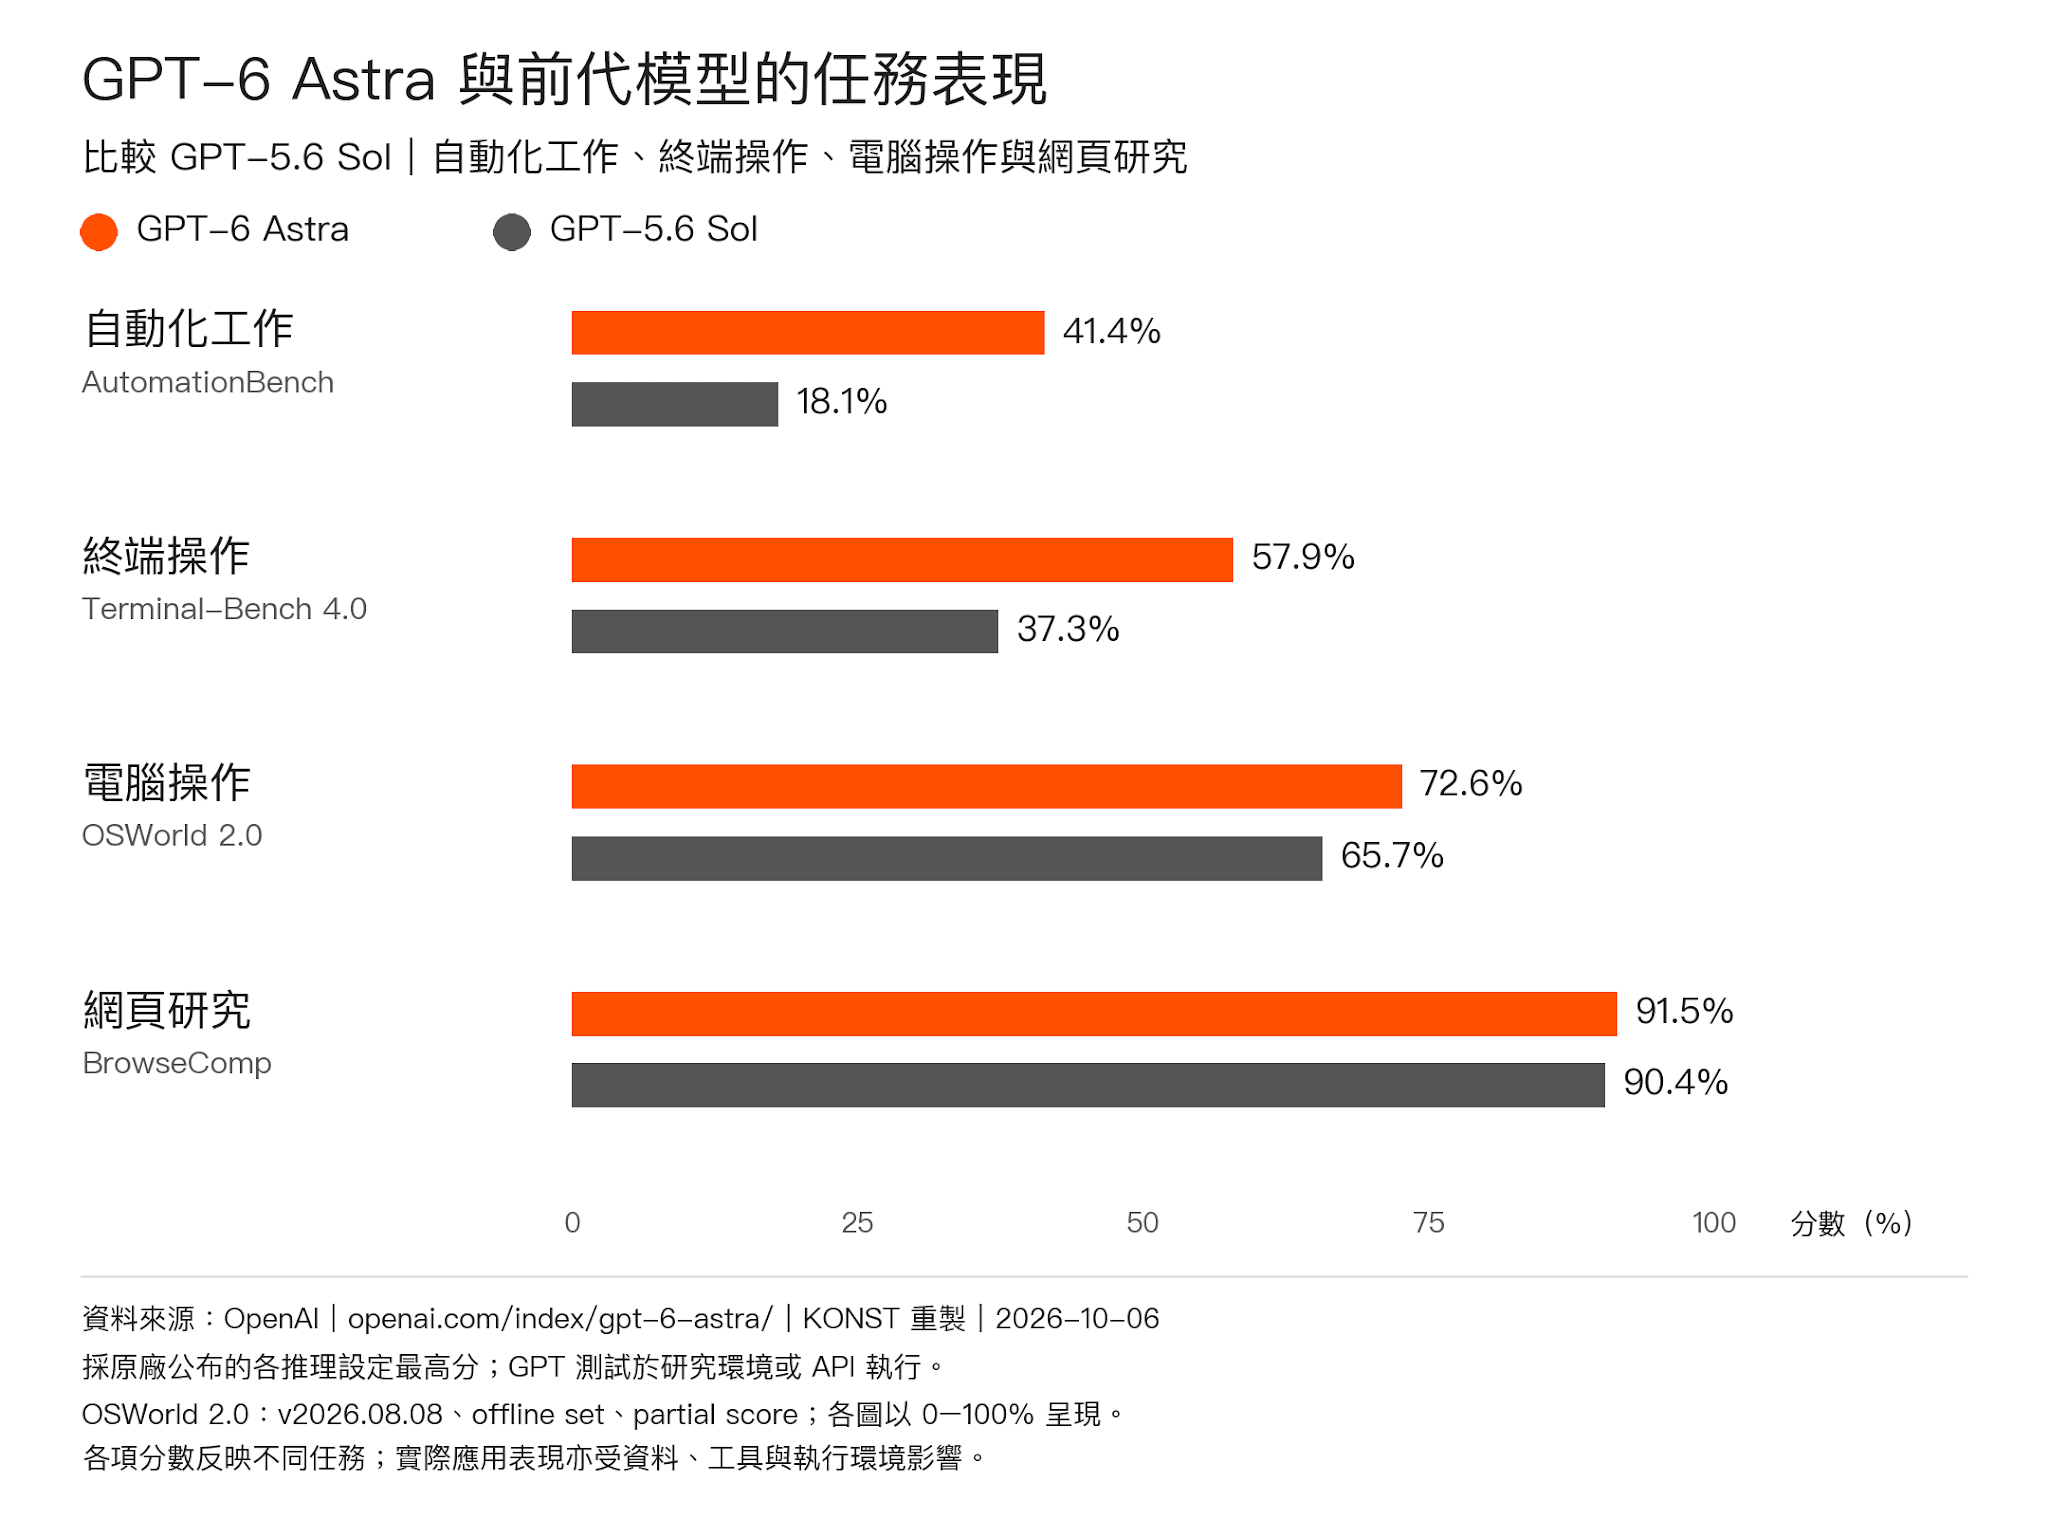
圖:GPT-6 Astra 與 GPT-5.6 Sol 的四項任務評測。資料來源:OpenAI;KONST 重製,評測版本與條件見圖內註記。
四項評測對應自動化工作、終端操作、電腦操作與網頁研究。Astra 與 GPT-5.6 Sol 在自動化工作及終端操作的分數差距較大,網頁研究則較接近。對使用者而言,升級價值會隨任務改變:需要連續操作多個工具的工作,可優先測試完成率與人工介入次數;既有模型已能穩定完成的查找工作,則可進一步比較速度與成本。
Astra 能自己完成哪些工作?
在資料與工具備妥後,Astra 可用於研究整理、文件產出及程式修改等工作。規劃任務時,應同時定義交付成果與完成條件,讓「做完」有可檢查的標準。
以下三種任務,可用交付成果、必要工具與驗證方式來規劃:
| 任務 | 可交付的成果 | 必要環境與驗證方式 |
|---|---|---|
| 研究整理 | 主題摘要、比較表與來源連結 | 提供搜尋或文件讀取工具;確認來源日期、引用及推論是否成立 |
| 文件產出 | 依既有模板完成報告或提案 | 提供原始資料、範例與檔案工具;檢查數字、結構與版面 |
| 程式修改 | 修正程式並完成相關檢查 | 提供程式庫及執行環境;驗證需求、測試結果與變更範圍 |
以研究報告為例,任務可以從「幫我研究市場」具體化為「比較三種方案,附上資料日期及來源,依指定模板產出報告」。AI 便有較清楚的選材與交付依據。若中途出現資料缺漏,也能判斷應繼續研究、標示未知,或向使用者詢問。
對外寄送、發布內容或修改正式系統等動作,還需要應用端設定權限與確認流程。能生成成果,與能代表企業執行外部動作,是不同層次的授權。
Astra 還有哪些限制?哪些人值得升級?
值得優先評估 Astra 的使用者,是經常處理長任務、跨工具工作,且目前花很多時間補充指示或修正成果的人。若既有模型已能穩定完成工作,則應先確認升級能帶來多少實際改善。
Astra 仍可能誤讀資料、漏掉限制,或產生需要修正的內容;研究來源、計算結果及程式行為仍要驗證。能連續執行多個步驟,也會讓前面的錯誤影響後續成果,因此完成任務後應按原始需求覆核。
能力提升仍伴隨使用上的取捨。OpenAI 的使用指南指出,Astra 有時可能過度謹慎、提供過多細節,或做超出需要的檢查。團隊可以明確交代完成標準、可自行決定的範圍,以及哪些情況需要停下詢問,減少不必要的往返。
評估時,可以選取一批具代表性的真實任務,在相同資料、工具與完成標準下比較:
- 成果品質:資料與計算是否正確,是否符合原始需求。
- 人工投入:需要補充幾次指示,覆核及修改花多少時間。
- 完成效率:從提出需求到取得可用成果,總共需要多久。
- 總成本:模型與工具費用,加上人工處理及失敗重做的投入。 對團隊而言,單次回覆較快或單位 Token 較便宜,都只是部分指標。若高能力模型能減少多次返工,可能更有使用價值;若只是處理大量固定格式的簡單任務,較輕量的模型也可能足夠。兩種判斷都需要以實際工作驗證。
透過 Horizon AI 的 ATP Token 平台使用 Astra
未來智慧(Horizon AI)提供 AI 應用導入與模型資產治理服務。Horizon AI 的 ATP Token 平台已可使用 GPT-6 Astra,企業可透過平台將 Astra 接入應用,並集中管理多模型使用、專案權限與用量。
透過 ATP Token 平台,團隊可依專案建立金鑰、設定可使用的模型,並查看使用紀錄及費用歸屬。接入流程從建立專案與金鑰開始,再依開發文件設定 API 端點,選擇 Astra 執行測試。
ATP Token 也提供 Claude、Gemini 等模型選擇。團隊可用同一批研究、文件或程式任務,比較成果品質、回應時間與使用成本,再為不同工作選擇合適的模型。
開始透過 Horizon AI 的 ATP Token 平台使用 Astra,或與 KONST 討論企業 AI 應用與模型接入需求。